

Las buenas prácticas de ClickHouse se reducen a una idea incómoda: el motor casi nunca es el problema. ClickHouse es brutalmente rápido cuando lo usas como fue diseñado, y sorprendentemente lento cuando lo tratas como un PostgreSQL con esteroides.
Casi todos los problemas de rendimiento en producción son autoinfligidos: una ORDER BY mal elegida, inserciones fila por fila, un FINAL en el camino caliente, un JOIN al revés. No son límites del motor. Son decisiones tuyas, y casi todas se toman el día que escribes el CREATE TABLE.
Esta guía recoge las reglas que sí o sí debes cumplir para optimizar ClickHouse en producción, con el porqué de cada una y, cuando se puede medir, con la medición delante.
En una frase: elige la
ORDER BYpor tus filtros reales, inserta en lotes grandes, no usesSELECT *niFINAL, pon la tabla pequeña a la derecha delJOIN, protege cada consumidor con perfil y cuota, y mide conEXPLAIN indexes = 1ysystem.query_logen vez de adivinar.
Lo que cubre esta guía:
Cómo elegir la
ORDER BYy por qué laPRIMARY KEYdebería ser más cortaParticionado, tipos, zonas horarias y códecs de compresión
Ingesta por lotes,
async_insert, deduplicación yTOO_MANY_PARTSIngesta desde Kafka sin perder eventos
Consultas: poda del índice,
FINAL,JOINy memoriaCuándo usar un índice de salto, una proyección o una vista materializada
Replicación, Keeper, sharding y consultas distribuidas
Seguridad, cuotas y multi-tenancy
Migraciones de esquema y backups que de verdad restauran
Observabilidad, antipatrones, preguntas frecuentes y checklist
Al final tienes el entorno Docker para reproducirlo todo en tu máquina en cinco minutos.
1. Cómo elegir la ORDER BY en ClickHouse
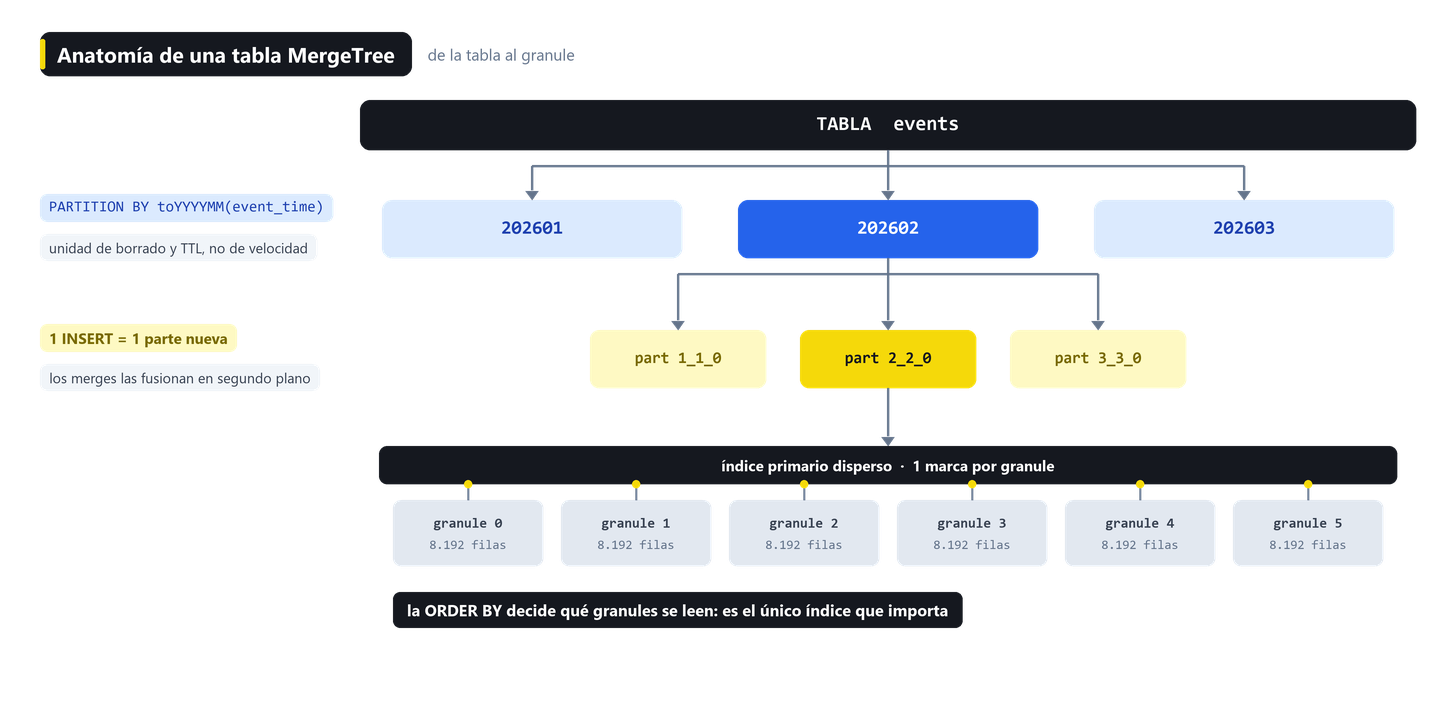
En MergeTree, la clave de ordenamiento define el índice primario, que es disperso: una marca cada 8.192 filas (index_granularity). ClickHouse no busca filas, descarta bloques de 8.192. Todo lo demás —códecs, proyecciones, índices de salto— es secundario frente a esta decisión.
Las reglas:
Ordena las columnas de menor a mayor cardinalidad.
Pon primero las columnas por las que siempre filtras.
Mantenla corta: de 2 a 4 columnas. Más columnas rara vez ayudan y encarecen los merges.
La marca de tiempo casi nunca va primero: suele ser la columna de mayor cardinalidad.
-- Mal: el timestamp primero mata la poda por tenant
CREATE TABLE events (...)
ENGINE = MergeTree
ORDER BY (event_time, tenant_id, user_id);

-- Bien: filtras por tenant, luego acotas por tiempo
CREATE TABLE events
(
    tenant_id   UInt32,
    event_type  LowCardinality(String),
    user_id     UInt64,
    event_time  DateTime('UTC') CODEC(Delta, ZSTD(1)),
    duration_ms UInt32          CODEC(T64, ZSTD(1)),
    revenue     Decimal(18,4),
    payload     String          CODEC(ZSTD(3))
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(event_time)
PRIMARY KEY (tenant_id, event_type)
ORDER BY (tenant_id, event_type, event_time, user_id)
SETTINGS index_granularity = 8192;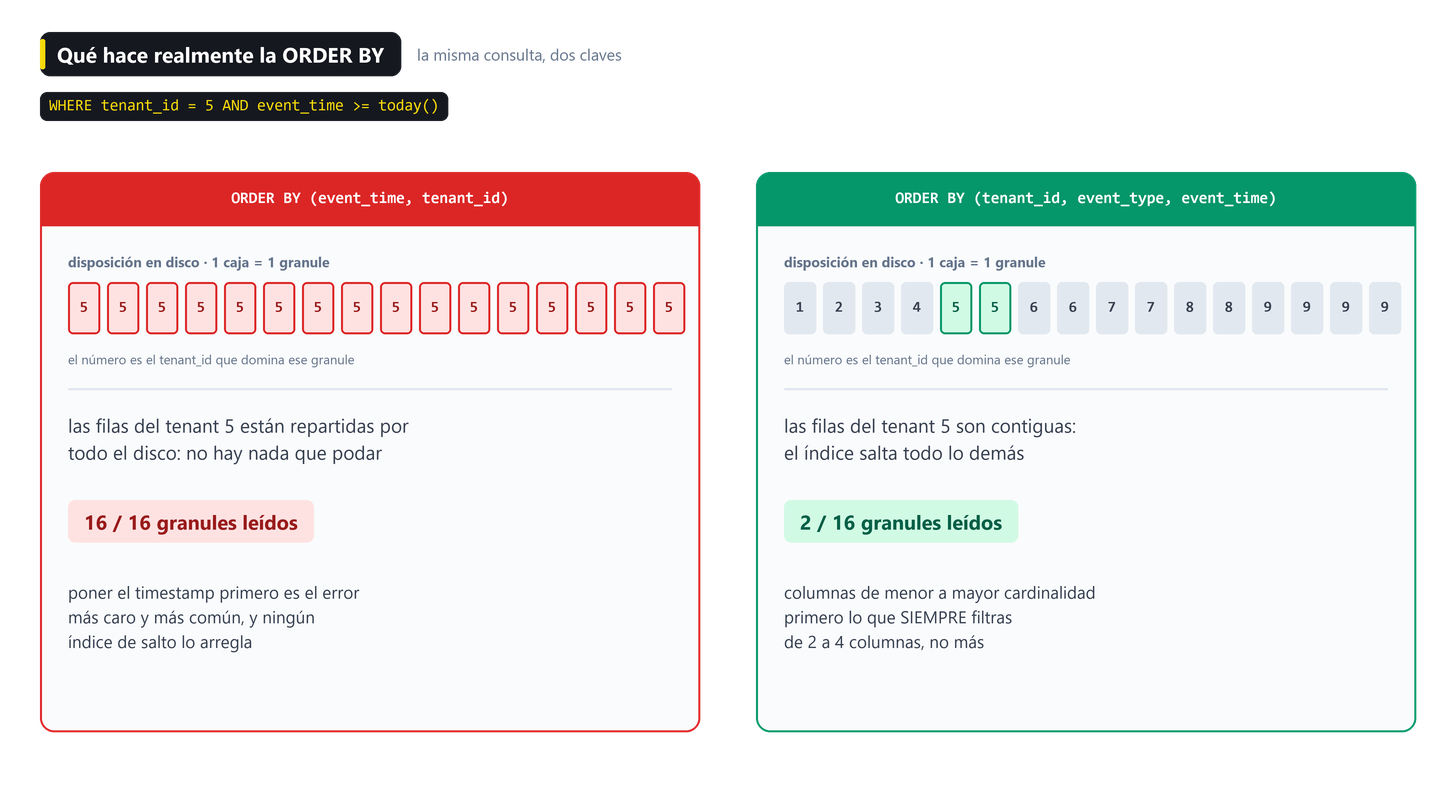
La diferencia, medida
Sobre una tabla de dos millones de filas, la misma consulta con y sin el prefijo de la ORDER BY:
consulta                       marcas  filas leídas   bytes leídos
con prefijo de la ORDER BY          3      24.580         192 KiB
sin prefijo                        93     757.150        2,89 MiB
Treinta veces menos filas, quince veces menos bytes, y el mismo resultado. En una tabla de mil millones de filas esa proporción es la diferencia entre un dashboard y un incidente.
No lo supongas: míralo.
EXPLAIN indexes = 1
SELECT count()
FROM events
WHERE tenant_id = 5 AND event_time >= now() - INTERVAL 1 DAY;
Si el plan muestra que lee todas las partes y todos los granules, tu WHERE no está tocando el prefijo de la clave. Y no envuelvas la columna indexada en funciones: WHERE toDate(event_time) = today() dificulta la poda, WHERE event_time >= today() AND event_time < today() + 1 no.
La PRIMARY KEY puede ser más corta que la ORDER BY
Esta es la optimización avanzada que casi nadie aplica. PRIMARY KEY debe ser un prefijo de ORDER BY, pero no tiene por qué ser igual de larga. Las marcas del índice primario viven en RAM: si tu ORDER BY termina en una columna de altísima cardinalidad que solo necesitas para ordenar dentro del granule, déjala fuera de la PRIMARY KEY y te ahorras memoria en cada réplica.
SELECT
    t.primary_key AS clave_primaria,
    t.sorting_key AS clave_de_orden,
    formatReadableSize(sum(p.primary_key_bytes_in_memory)) AS marcas_en_ram
FROM system.tables AS t
INNER JOIN system.parts AS p
    ON p.database = t.database AND p.table = t.name
WHERE t.database = currentDatabase() AND t.name = 'events' AND p.active
GROUP BY clave_primaria, clave_de_orden;
No existe una ORDER BY buena para todos los patrones de consulta. Si tienes dos patrones muy distintos, la respuesta es una proyección o una tabla aparte, nunca una clave de compromiso que sirve mal a ambos.
2. Particionado: cuántas particiones aguanta una tabla
La partición es una unidad de gestión de datos (borrado, TTL, mover a almacenamiento frío), no un mecanismo de aceleración. Eso lo hace la ORDER BY.
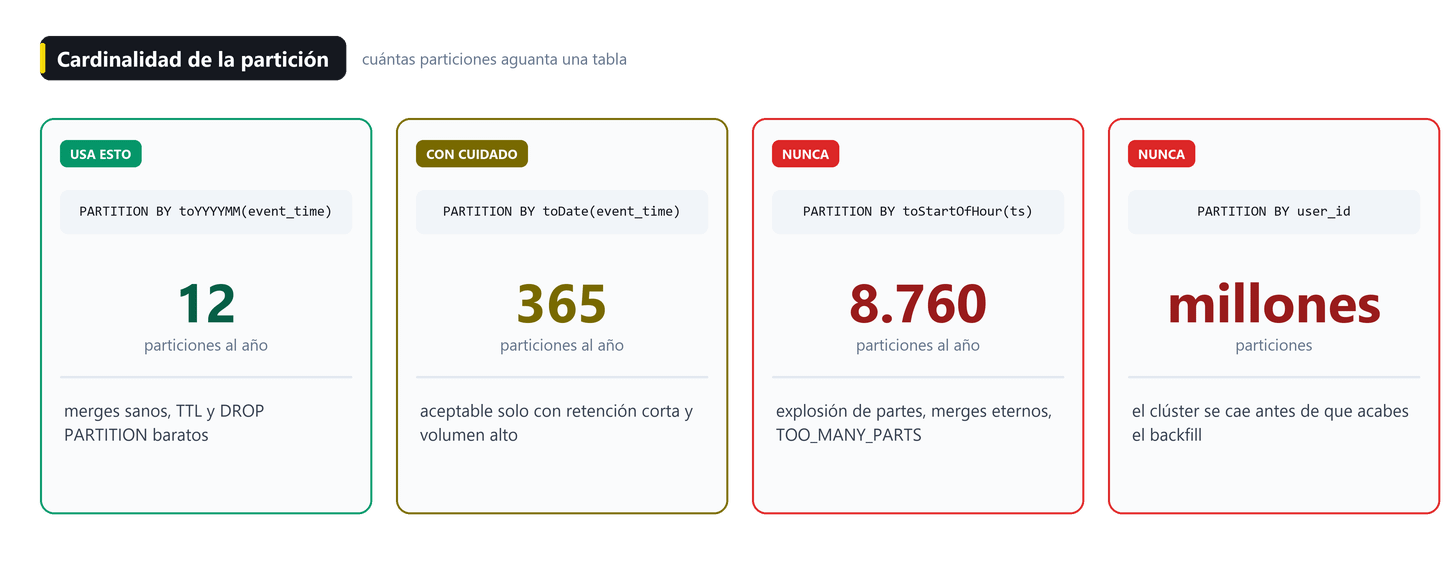
Objetivo: decenas o pocos cientos de particiones por tabla, nunca miles. Y si no necesitas borrar por rango, puedes no particionar: es una opción perfectamente válida y a menudo la correcta.
Para expirar datos, TTL y nunca un cron con DELETE:
ALTER TABLE events MODIFY TTL event_time + INTERVAL 365 DAY DELETE;Si además quieres enfriar antes de borrar (TO VOLUME 'cold'), necesitas una storage_policy configurada en el servidor con ese volumen definido; sin ella el ALTER falla. Ese es el camino habitual para mover datos antiguos a S3 y pagar almacenamiento de objetos en vez de NVMe.
3. Tipos y códecs: la compresión es velocidad
El tipo de dato no es una cuestión de pulcritud. Menos bytes en disco son menos bytes que descomprimir, y la descompresión es tiempo de CPU en cada consulta.
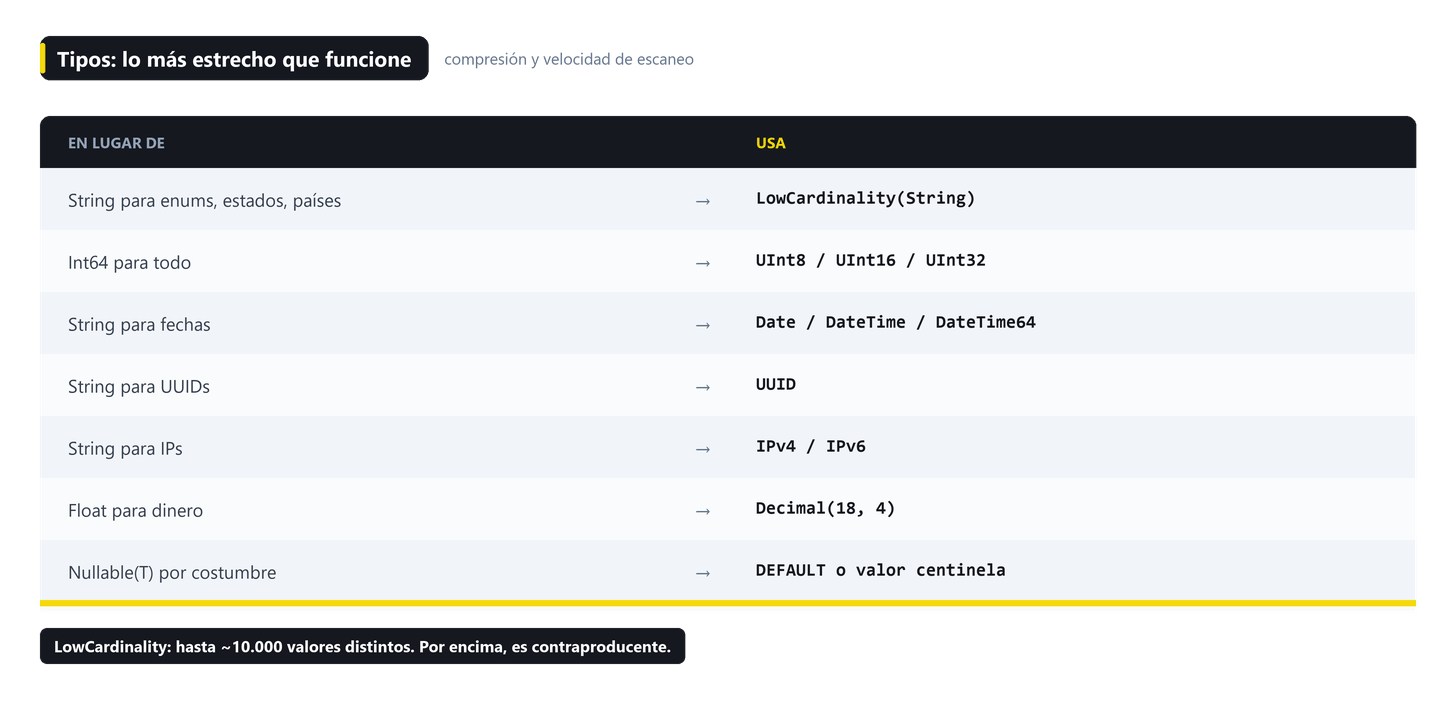
LowCardinality es la victoria más barata de toda la lista. Dos tablas con exactamente los mismos dos millones de valores, una con String y otra con LowCardinality(String):
tabla        comprimido    sin comprimir
t_lowcard     30,50 KiB        1,92 MiB
t_string     126,68 KiB       26,32 MiB
Cuatro veces menos en disco y, sobre todo, catorce veces menos trabajo de descompresión. Aplícalo a cualquier String con menos de unos 10.000 valores distintos; por encima de esa cifra empieza a ser contraproducente.
Sobre Nullable: añade una columna de máscara aparte, con más I/O, peor compresión y menos optimizaciones. Usa un valor centinela o DEFAULT, salvo que la diferencia entre “cero” y “desconocido” sea semánticamente necesaria. Y nunca pongas una columna Nullable en la ORDER BY.
Pon la zona horaria en el tipo, no en la cabeza
Esta es la bomba de relojería más barata de desactivar. Un DateTime sin zona horaria usa la del servidor, y el día que migras de máquina o cambias el timezone del contenedor, todos tus informes se desplazan una hora sin que nadie se entere.
CREATE TABLE eventos_utc
(
    id       UInt64,
    ocurrido DateTime('UTC') CODEC(Delta, ZSTD(1))
)
ENGINE = MergeTree ORDER BY (ocurrido, id);
Guarda siempre en UTC y convierte en la capa de presentación. No al revés.
Códecs
Los códecs se eligen por la forma del dato, no por gusto:
DeltayDoubleDeltapara secuencias monótonas: timestamps, contadores, identificadores incrementales.GorillaoT64para flotantes y enteros de métricas.ZSTD(1..3)para texto y datos fríos, cuando el disco pesa más que la CPU.LZ4(el default) cuando la CPU pesa más que el disco.
Audita lo que de verdad está ocupando espacio, columna por columna:
SELECT
    column,
    formatReadableSize(sum(column_data_compressed_bytes))   AS comprimido,
    formatReadableSize(sum(column_data_uncompressed_bytes)) AS crudo,
    round(sum(column_data_uncompressed_bytes)
        / sum(column_data_compressed_bytes), 1)             AS ratio
FROM system.parts_columns
WHERE active AND table = 'events' AND database = currentDatabase()
GROUP BY column
ORDER BY sum(column_data_compressed_bytes) DESC;
La columna con peor ratio y más peso es siempre la primera candidata a un códec distinto o a un tipo más estrecho.
Y si el esquema no lo controlas tú
Para payloads semiestructurados que cambian sin avisar, ClickHouse tiene un tipo JSON nativo que crea subcolumnas sobre la marcha, en vez de obligarte a guardar un String y parsearlo en cada consulta:
CREATE TABLE eventos_json (id UInt64, payload JSON)
ENGINE = MergeTree ORDER BY id;

INSERT INTO eventos_json VALUES (1, '{"a": 1, "b": {"c": "x"}}');

SELECT id, payload.a, payload.b.c FROM eventos_json;
Úsalo para lo que de verdad es variable. Las columnas que consultas siempre merecen ser columnas de verdad, con su tipo y su códec.
4. Ingesta: por qué fila a fila rompe el clúster
Cada INSERT crea una parte en disco. Las partes se fusionan en segundo plano. Si insertas fila por fila, generas miles de partes, el merge no da abasto y recibes TOO_MANY_PARTS.
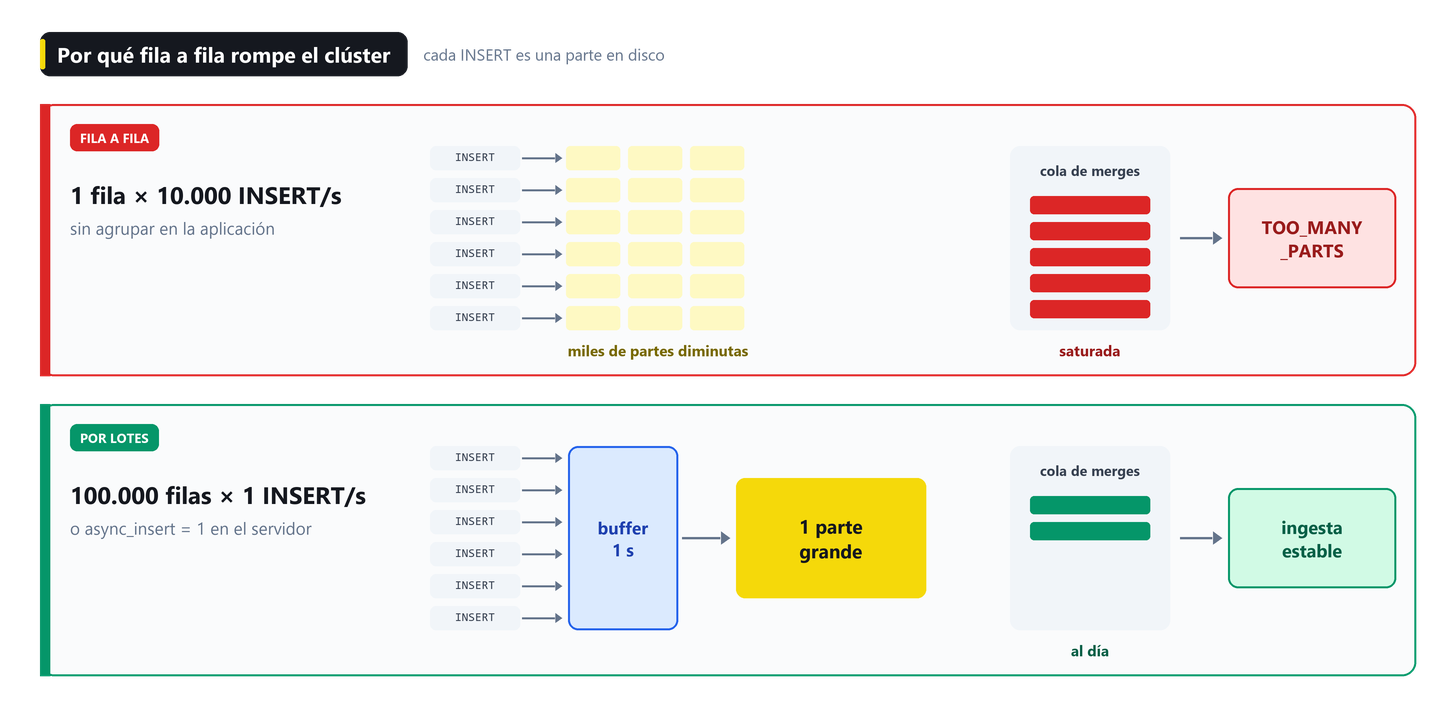
Los umbrales no son misteriosos, están en una tabla del sistema:
SELECT name, value
FROM system.merge_tree_settings
WHERE name IN ('parts_to_delay_insert', 'parts_to_throw_insert',
               'replicated_deduplication_window',
               'replicated_deduplication_window_seconds');
En ClickHouse 26.9 los valores por defecto son 1.000 partes activas por partición para empezar a retrasar los INSERT y 3.000 para rechazarlos. Si estás rozando el primero, ya tienes un problema: el segundo llega en cuestión de horas.
De 10.000 a 100.000 filas o más por INSERT, y como máximo una inserción por segundo y por tabla desde cada productor. Si tienes muchos clientes concurrentes y pequeños, no los coordines a mano: deja que el servidor agrupe.
INSERT INTO estados
SETTINGS async_insert = 1,
         wait_for_async_insert = 1,
         async_insert_busy_timeout_ms = 1000,
         async_insert_max_data_size = 10000000
VALUES (3, 'nuevo', 1);
wait_for_async_insert = 1 mantiene la garantía de durabilidad: el cliente recibe el acuse cuando el bloque está escrito. Ponerlo a 0 multiplica el rendimiento y te deja sin saber si el dato llegó. Es una decisión de negocio, no de ingeniería.
Si tu solución a
TOO_MANY_PARTSes subir el límite de partes, no has arreglado nada: has movido el incidente a la semana que viene.
Reintentos sin duplicados
Las tablas replicadas deduplican bloques idénticos automáticamente: guardan en Keeper la huella de los últimos 10.000 bloques insertados, durante una hora. Si tu reintento manda exactamente el mismo bloque dentro de esa ventana, no se duplica.
El problema es que casi ningún pipeline reenvía el bloque exactamente igual. Para eso existe el token explícito:
INSERT INTO estados
SETTINGS insert_deduplication_token = 'lote-2026-10-09-0001'
VALUES (4, 'nuevo', 1);
Con un token derivado del lote de origen (offset de Kafka, id de fichero, rango de fechas), tu pipeline puede reintentar sin miedo y sin lógica de deduplicación en la aplicación.
Dos detalles más que ahorran incidentes: nombra siempre las columnas (INSERT INTO t (a, b, c) ...) para que un ALTER TABLE ADD COLUMN no te rompa la ingesta, y usa formatos nativos (Native o RowBinary por encima de Parquet, y Parquet por encima de JSONEachRow), con compresión activada en el cliente.
Actualizar y borrar es excepcional
ALTER TABLE ... UPDATE y DELETE son mutaciones: reescriben partes completas de forma asíncrona. No son transacciones y no son baratas.
Para corregir datos:
DROP PARTITIONy reinsertar.Para “última versión gana”:
ReplacingMergeTree.Para borrados puntuales:
DELETE FROM ... WHERE ...(ligero, marca filas), entendiendo que la fila sigue en disco hasta el siguiente merge.Para expiración por antigüedad:
TTL.
Cuando lances una mutación y necesites esperar a que termine, SETTINGS mutations_sync = 2. Y vigila las que se quedan atascadas, que es un clásico silencioso:
SELECT database, table, mutation_id, command, parts_to_do, latest_fail_reason
FROM system.mutations
WHERE NOT is_done;
5. Ingesta desde Kafka sin perder eventos
Kafka es el origen más común de datos en ClickHouse, y también el que más gente monta mal. La tabla con ENGINE = Kafka no es una tabla: es un consumidor. Leer de ella consume del topic, y lo que lees desaparece para el resto.
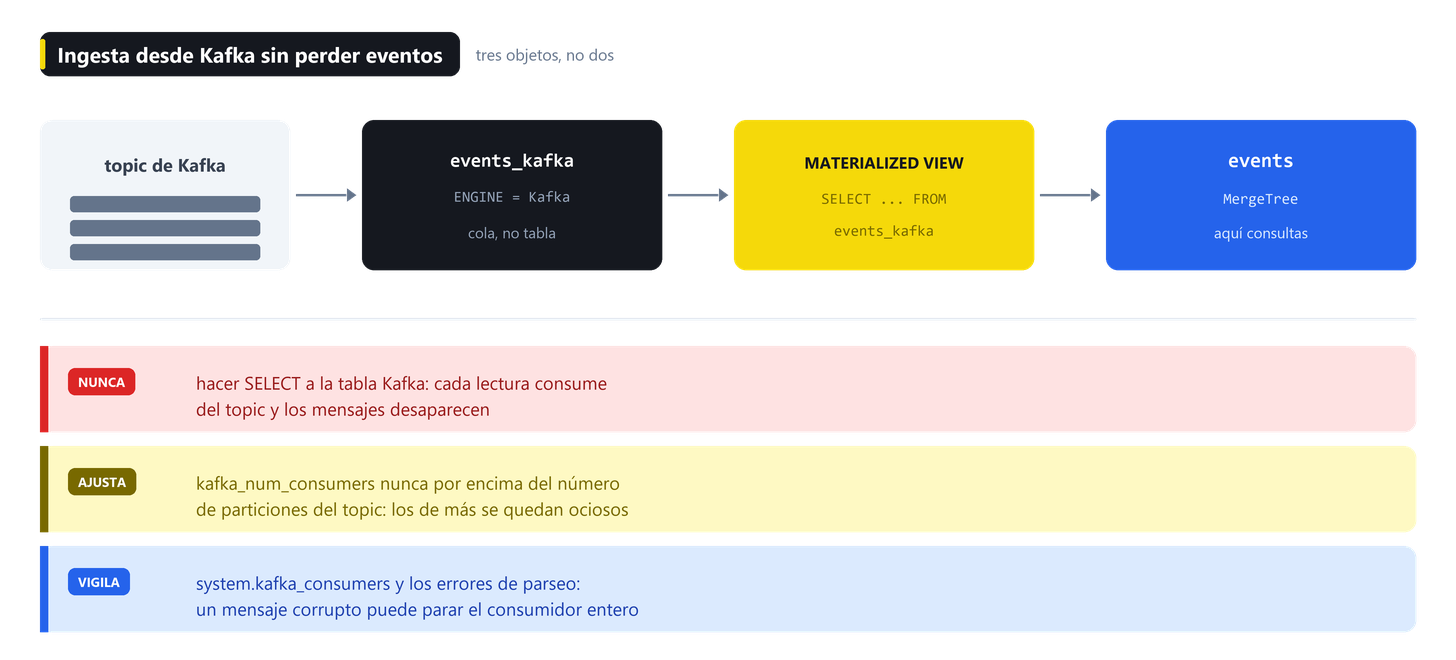
Hacen falta tres objetos, no dos: la cola, la vista que la vacía y la tabla donde viven los datos.
CREATE TABLE events_kafka
(
    tenant_id  UInt32,
    event_type String,
    user_id    UInt64,
    event_time DateTime
)
ENGINE = Kafka
SETTINGS kafka_broker_list = 'kafka:9092',
         kafka_topic_list = 'events',
         kafka_group_name = 'clickhouse-events',
         kafka_format = 'JSONEachRow',
         kafka_num_consumers = 3,
         kafka_max_block_size = 1048576,
         kafka_handle_error_mode = 'stream';

CREATE MATERIALIZED VIEW mv_kafka_events TO events AS
SELECT tenant_id, event_type, user_id, event_time
FROM events_kafka;
Las reglas que evitan el 90% de los incidentes:
Nunca hagas
SELECTa la tabla Kafka para “ver si llegan datos”. Cada consulta consume mensajes que ya no llegarán a la vista materializada. Si quieres inspeccionar, mira la tabla destino.kafka_num_consumersnunca por encima del número de particiones del topic. Los consumidores sobrantes se quedan ociosos ocupando hilos.kafka_handle_error_mode = 'stream'manda los mensajes que no parsean a un flujo de errores en vez de bloquear el consumidor. Sin esto, un solo mensaje corrupto puede parar la ingesta entera.Una vista materializada por destino. Si necesitas escribir en tres tablas, son tres vistas sobre la misma cola, no una vista con tres
INSERT.Vigila
system.kafka_consumers: ahí se ve el retraso, las excepciones y si el consumidor está vivo.
Para idempotencia real de extremo a extremo, usa el offset de Kafka en el insert_deduplication_token de la sección anterior. Es la forma más simple de aproximarse a exactly-once sin inventar un sistema de control de estado.
6. Consultas: lo que cuesta caro
Nunca SELECT *
ClickHouse es columnar. SELECT * lee todas las columnas del disco y anula la principal ventaja del motor. Pide solo lo que necesitas. Siempre.
Evita FINAL en el camino caliente
FINAL fuerza la fusión en tiempo de consulta. Es correcto, y es lento. Para ReplacingMergeTree, agrega explícitamente:
SELECT
    id,
    argMax(status, version) AS estado_actual,
    max(version)            AS ultima_version
FROM estados
GROUP BY id;
Ojo con los alias, porque aquí hay una trampa que la mayoría de artículos copia mal. Esta variante, que circula por todas partes, falla en ClickHouse moderno:
-- NO funciona: Code 184, aggregate function inside another aggregate function
SELECT id, argMax(status, version) AS status, max(version) AS version
FROM estados
GROUP BY id;
Al llamar version al alias de max(version), el analizador resuelve el version de dentro de argMax contra el alias, y acabas con una agregación dentro de otra. Dale a los alias nombres distintos de las columnas que agregas.
Y nunca ejecutes OPTIMIZE TABLE ... FINAL de forma periódica sobre tablas grandes: reescribe todo y es la causa habitual de clústeres saturados.
Haz los JOIN en el orden correcto
ClickHouse carga la tabla derecha en memoria para construir la hash table. El orden no es una preferencia del optimizador: es la diferencia entre 200 ms y un MEMORY_LIMIT_EXCEEDED.
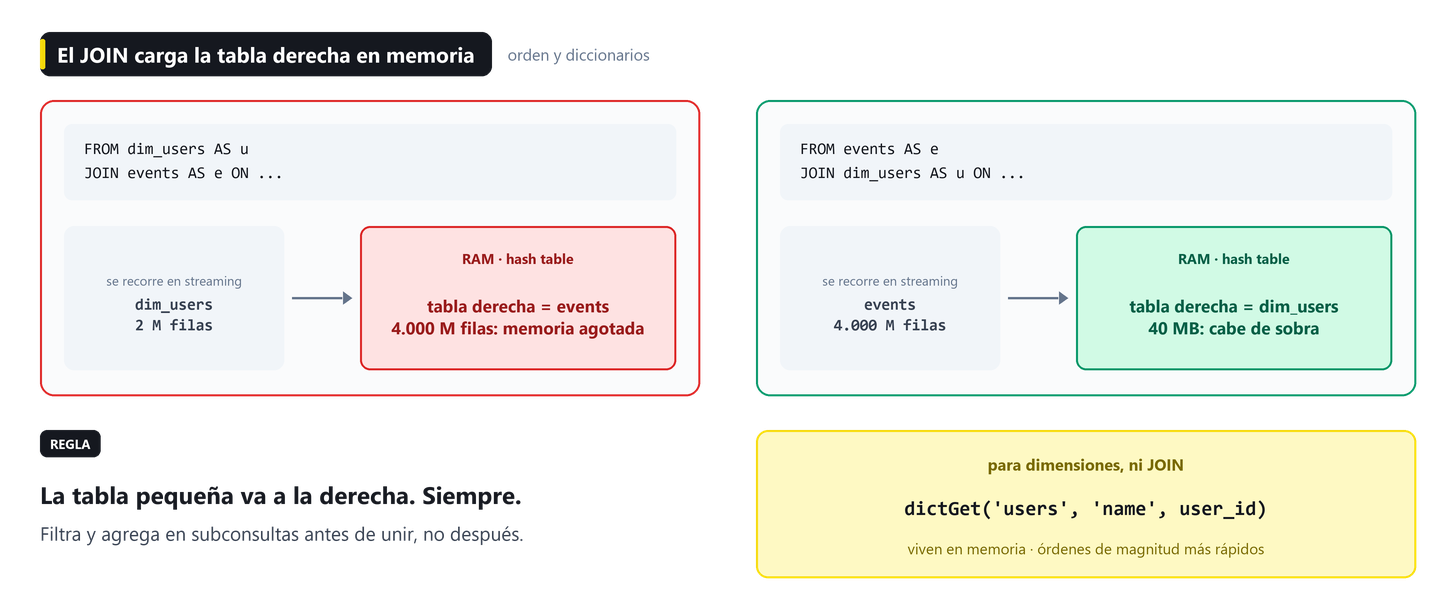
Filtra y agrega en subconsultas antes de unir, no después. Y si la tabla derecha realmente no cabe, cambia de algoritmo antes que de límite de memoria:
SELECT count()
FROM events AS e
JOIN estados AS s ON e.user_id = s.id
SETTINGS join_algorithm = 'grace_hash';
Para dimensiones, lo correcto no es un JOIN mejor, sino ningún JOIN. Un diccionario vive en memoria, se refresca solo y se consulta con una función:
CREATE DICTIONARY dim_tenants
(
    tenant_id UInt32,
    nombre    String,
    plan      String
)
PRIMARY KEY tenant_id
SOURCE(CLICKHOUSE(QUERY $q$
    SELECT tenant_id, nombre, plan FROM dim.tenants
$q$))
LAYOUT(HASHED())
LIFETIME(MIN 600 MAX 900);

SELECT
    dictGet('dim_tenants', 'nombre', toUInt64(tenant_id)) AS tenant,
    count() AS eventos
FROM events
WHERE event_time >= now() - INTERVAL 1 DAY
GROUP BY tenant
ORDER BY eventos DESC;
Aproxima cuando puedas
uniq() en lugar de count(DISTINCT), uniqCombined si necesitas ajustar memoria y precisión, quantile() en lugar de quantileExact(). Reserva las versiones exactas para cuando el negocio realmente las exija, que es menos a menudo de lo que la gente cree.
Pon límites a cada consulta
Un cliente mal escrito no debe poder tumbar el clúster.
SELECT count() FROM events
SETTINGS max_execution_time = 60,
         max_memory_usage = 10000000000,
         max_rows_to_read = 1000000000,
         max_result_rows = 100000,
         max_bytes_before_external_group_by = 2000000000;
max_bytes_before_external_group_by es el que evita que una agregación enorme muera: a partir de ese umbral vuelca a disco en vez de reventar. Pero no lo escribas consulta a consulta: eso es la sección 9.
Y si tienes un dashboard que repite la misma consulta cada quince segundos, la caché de consultas sale casi gratis:
SELECT count() FROM events WHERE tenant_id = 7
SETTINGS use_query_cache = 1, query_cache_ttl = 60;
7. Índice de salto, proyección o vista materializada
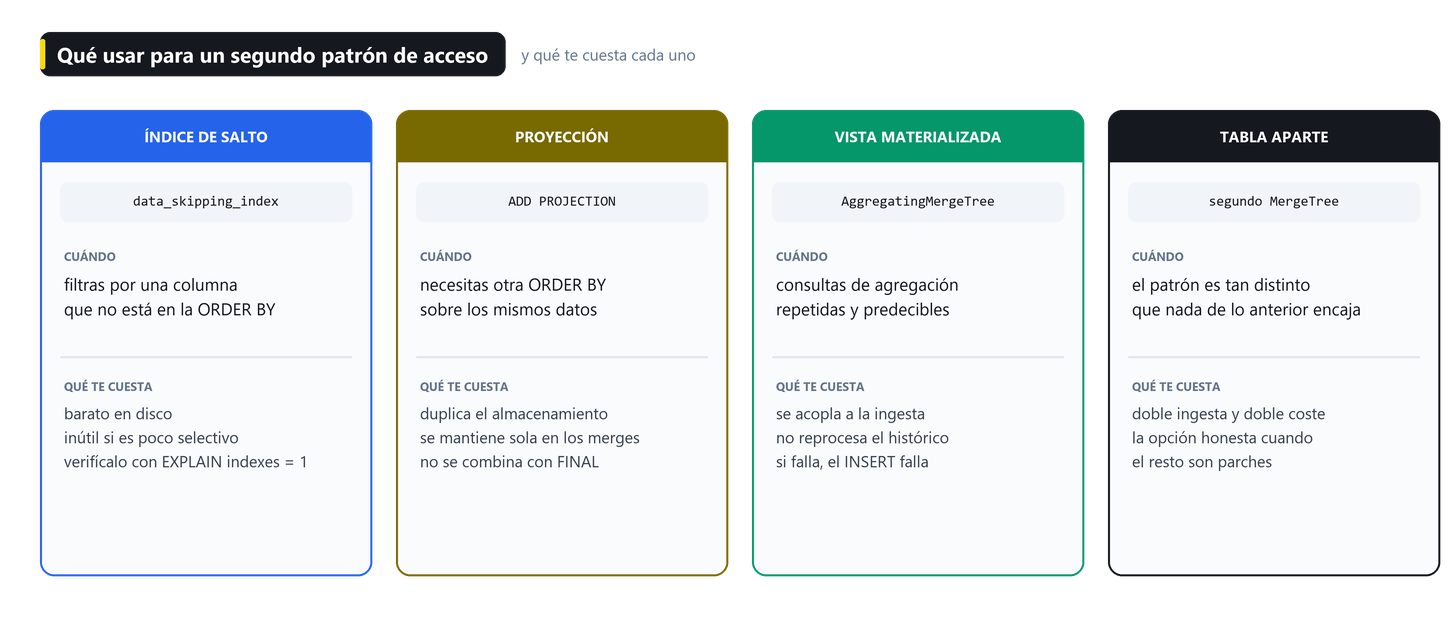
Cuando aparece un segundo patrón de acceso, hay cuatro respuestas posibles y cada una te cobra algo distinto. Elegir mal aquí es el error de arquitectura más caro de revertir.
Índice de salto
ALTER TABLE events
    ADD INDEX idx_user user_id TYPE bloom_filter(0.01) GRANULARITY 4;

ALTER TABLE events MATERIALIZE INDEX idx_user SETTINGS mutations_sync = 2;
Barato en disco, pero inútil si es poco selectivo: si el valor buscado aparece en casi todos los granules, el índice no descarta nada y solo has añadido coste de escritura. El GRANULARITY del índice multiplica los granules que cubre cada entrada; afinarlo importa tanto como el tipo. Verifícalo siempre con EXPLAIN indexes = 1.
Proyección
Una proyección es una segunda copia de los datos con otra ORDER BY, mantenida por el propio motor durante los merges:
ALTER TABLE events ADD PROJECTION by_user
(
    SELECT tenant_id, user_id, event_time, duration_ms
    ORDER BY (user_id, event_time)
);

ALTER TABLE events MATERIALIZE PROJECTION by_user
SETTINGS mutations_sync = 2;
Medido sobre la misma tabla, con y sin proyección para un filtro por user_id:
modo               marcas  filas leídas   bytes leídos
con proyección          3      24.580         192 KiB
sin proyección         16     131.070        1,00 MiB
Para comprobar que el optimizador la está usando de verdad, hay dos herramientas: EXPLAIN projections = 1, que muestra ReadFromMergeTree (by_user) cuando entra, y SETTINGS force_optimize_projection = 1, que hace fallar la consulta si ninguna proyección se aplica. Esa segunda es perfecta para un test de regresión en CI.
El precio: duplica el almacenamiento de las columnas proyectadas y no se combina con FINAL.
Vista materializada
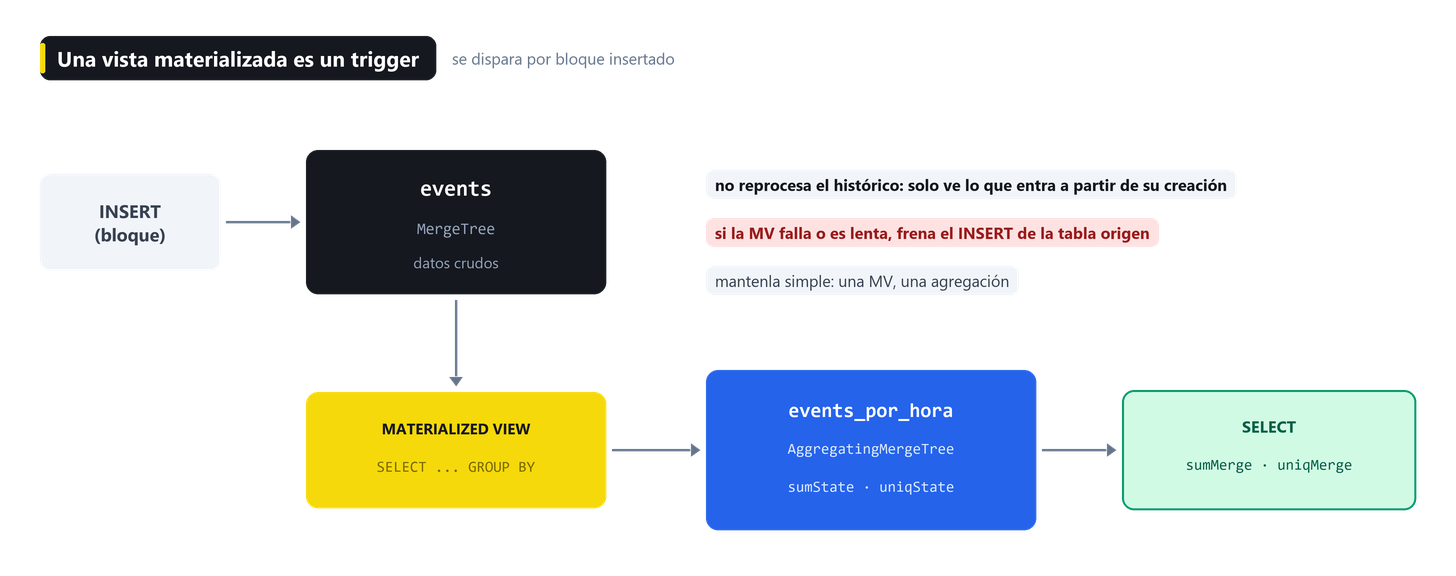
Una vista materializada en ClickHouse es un trigger de inserción: se dispara con cada bloque insertado en la tabla origen y escribe en la tabla destino.
CREATE TABLE events_por_hora
(
    tenant_id  UInt32,
    hora       DateTime,
    eventos    AggregateFunction(count),
    usuarios   AggregateFunction(uniq, UInt64),
    ingresos   AggregateFunction(sum, Decimal(18,4))
)
ENGINE = AggregatingMergeTree
ORDER BY (tenant_id, hora);

CREATE MATERIALIZED VIEW mv_events_por_hora TO events_por_hora AS
SELECT
    tenant_id,
    toStartOfHour(event_time) AS hora,
    countState()              AS eventos,
    uniqState(user_id)        AS usuarios,
    sumState(revenue)         AS ingresos
FROM events
GROUP BY tenant_id, hora;
Dos consecuencias que la gente descubre tarde. La primera: no reprocesa el histórico, solo ve lo que entra a partir de su creación. El backfill lo haces tú, a mano, y conviene hacerlo por rangos para no comerte la memoria:
INSERT INTO events_por_hora
SELECT
    tenant_id,
    toStartOfHour(event_time) AS hora,
    countState(),
    uniqState(user_id),
    sumState(revenue)
FROM events
WHERE event_time >= '2026-01-01' AND event_time < '2026-02-01'
GROUP BY tenant_id, hora;
La segunda: si la vista falla o es lenta, frena la ingesta de la tabla origen. Una vista materializada mal hecha no te da consultas lentas, te da un pipeline caído. Mantenlas simples: una vista, una agregación.
Y se lee siempre con las funciones -Merge, nunca directamente:
SELECT
    tenant_id,
    countMerge(eventos)  AS eventos,
    uniqMerge(usuarios)  AS usuarios,
    sumMerge(ingresos)   AS ingresos
FROM events_por_hora
WHERE hora >= now() - INTERVAL 7 DAY
GROUP BY tenant_id;
Tabla aparte
Cuando el patrón de acceso es tan distinto que nada de lo anterior encaja, la respuesta honesta es una segunda tabla alimentada por su propia vista materializada. Doble ingesta y doble almacenamiento, sí, pero sin parches que se rompen a los seis meses.
8. Clúster: replicación, Keeper y consultas distribuidas
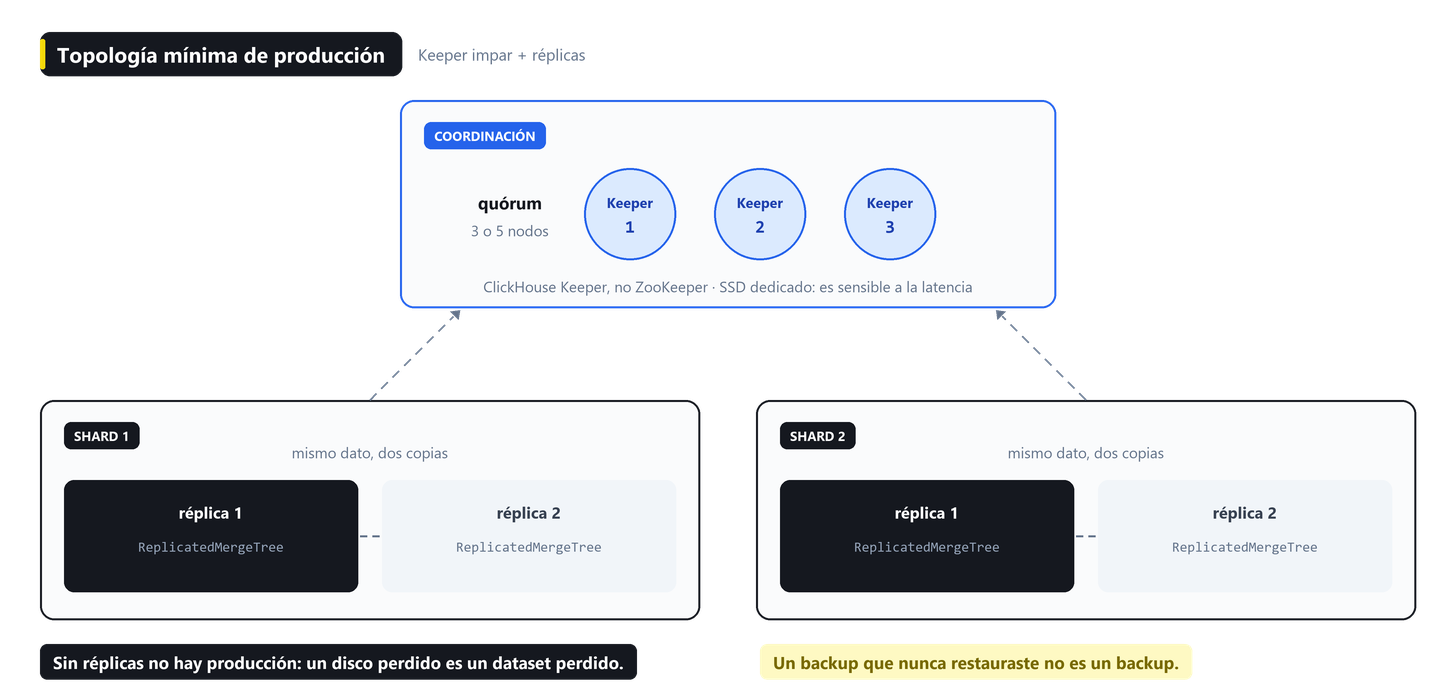
ReplicatedMergeTree y al menos dos réplicas para cualquier dato que te importe. La coordinación va con ClickHouse Keeper, no ZooKeeper, con 3 o 5 nodos (número impar) y disco rápido, porque es sensible a la latencia. Usa macros {shard} y {replica} en las rutas de las tablas replicadas para que el mismo DDL funcione en todo el clúster.
La clave de sharding importa más de lo que parece
CREATE TABLE events_distributed AS events
ENGINE = Distributed('default', currentDatabase(), events,
                     cityHash64(tenant_id));
Si repartes con rand(), los datos quedan perfectamente equilibrados y cada agregación por tenant tiene que cruzar la red. Si repartes con el hash de la columna por la que agrupas, cada shard puede resolver sus grupos en local. El precio es el desequilibrio: un tenant gigante satura su shard. Elige sabiendo lo que pagas.
Dónde se ejecuta cada parte de la consulta
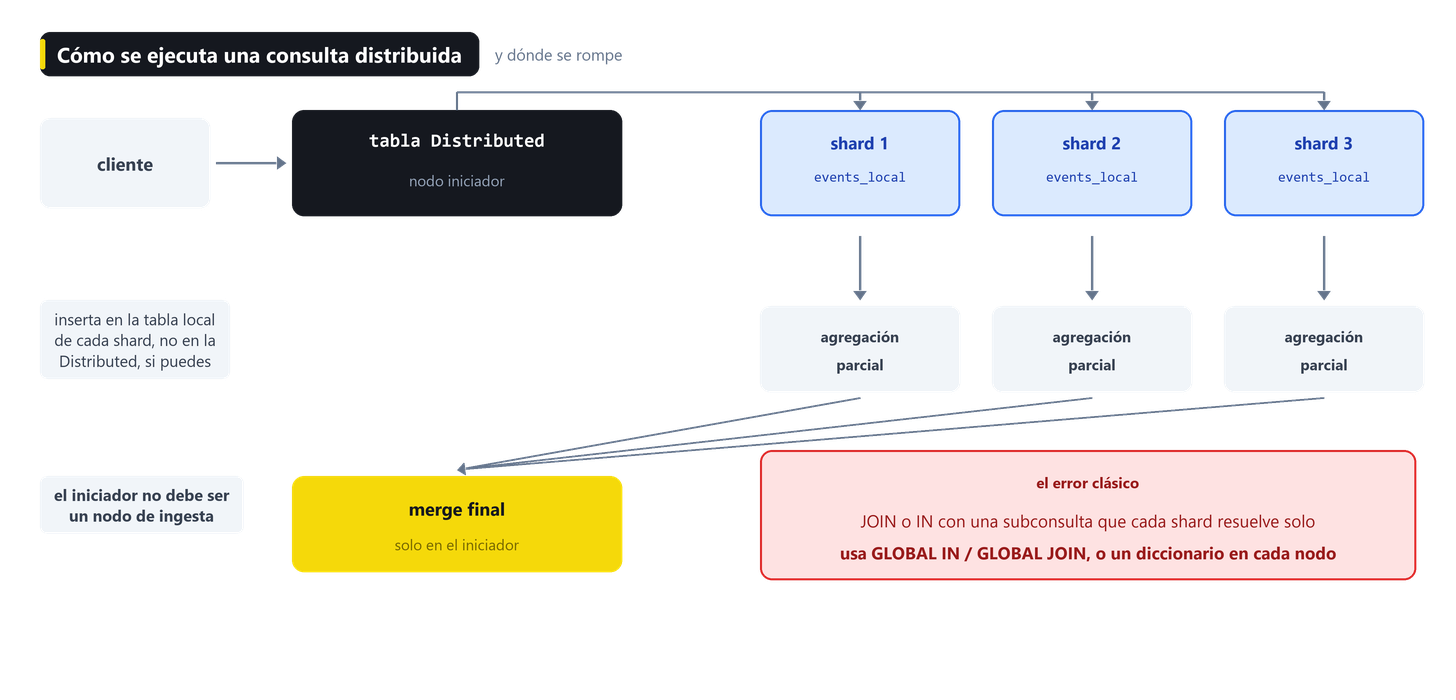
El iniciador reparte la consulta a los shards, cada shard agrega lo suyo sobre su tabla local, y el merge final ocurre en un único nodo. De ahí se derivan tres reglas:
El nodo iniciador no debería ser también un nodo de ingesta pesada.
Inserta en la tabla local de cada shard cuando puedas, en vez de en la
Distributed.Una subconsulta en un
INo unJOINse resuelve en cada shard por separado, lo que multiplica el trabajo y puede dar resultados incompletos. Para eso estánGLOBAL INyGLOBAL JOIN, que la resuelven una vez en el iniciador y reparten el resultado.
SELECT count()
FROM clusterAllReplicas('default', currentDatabase(), events)
WHERE user_id GLOBAL IN (SELECT id FROM estados);
9. Seguridad, cuotas y multi-tenancy
Esta es la sección que falta en casi todas las guías de ClickHouse, y la que más caro sale olvidar. Una base analítica acaba siempre con herramientas de BI, cuadernos de datos y gente del negocio conectada. Si solo tienes el usuario default, lo que tienes es un incidente pendiente de fecha.
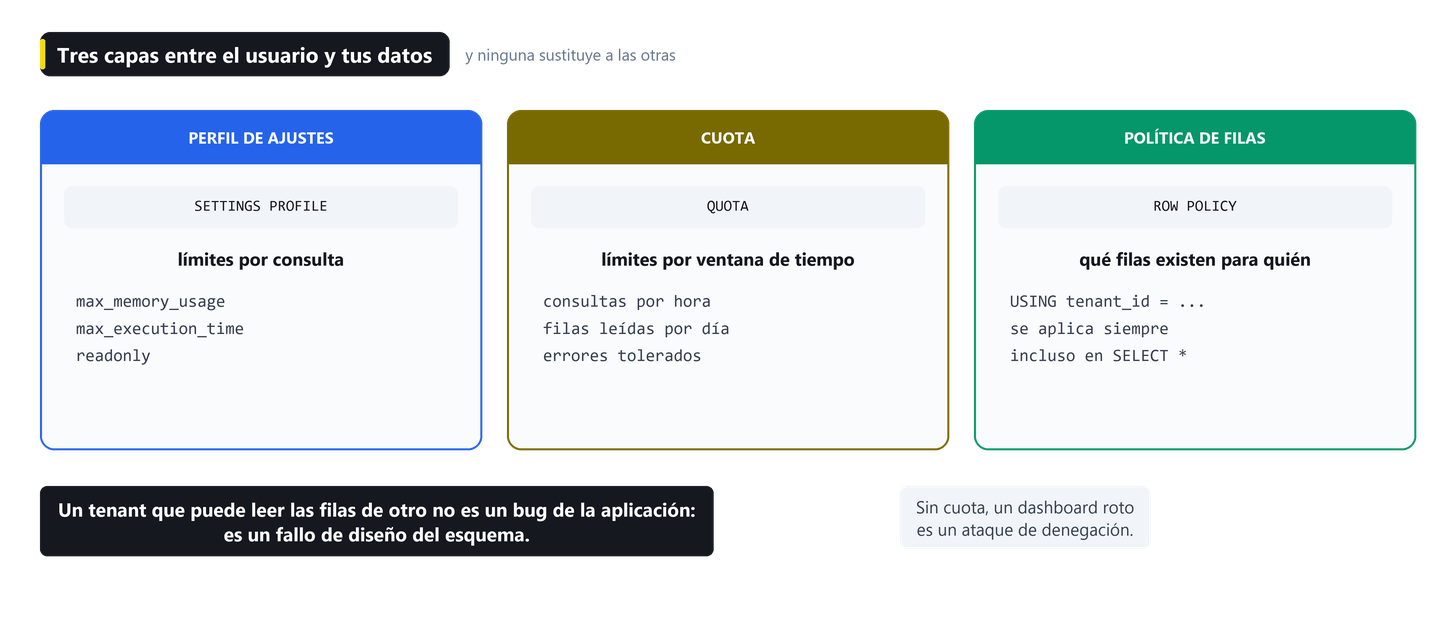
Son tres capas distintas y ninguna sustituye a las otras.
El perfil de ajustes limita cada consulta individual:
CREATE SETTINGS PROFILE bi_readonly SETTINGS
    max_execution_time = 30,
    max_memory_usage = 4000000000,
    max_rows_to_read = 500000000,
    max_result_rows = 100000,
    readonly = 1;

CREATE USER bi IDENTIFIED WITH sha256_password BY 'cambia-esto'
    SETTINGS PROFILE bi_readonly;

GRANT SELECT ON default.events TO bi;
La cuota limita el consumo acumulado en una ventana de tiempo, que es lo que el perfil no puede ver. Mil consultas de treinta segundos cada una pasan todos los límites por consulta y aun así tumban el clúster:
CREATE QUOTA bi_hora
    FOR INTERVAL 1 HOUR MAX queries = 1000, read_rows = 5000000000
    TO bi;
La política de filas decide qué filas existen para quién. Se aplica siempre, también en SELECT *, y es la única forma seria de hacer multi-tenancy sobre una tabla compartida:
CREATE ROW POLICY solo_mi_tenant ON default.events
    USING tenant_id = 5
    TO bi;
Un tenant que puede leer las filas de otro no es un bug de la aplicación: es un fallo de diseño del esquema. Y revisa lo que hay puesto de verdad, que la deriva de configuración es real:
SELECT short_name, database, table, select_filter, is_restrictive, apply_to_list
FROM system.row_policies
WHERE table = 'events';
Tres reglas más: el usuario default sin contraseña no sale del entorno de desarrollo, cada herramienta externa tiene su propio usuario (si todas comparten uno, no puedes revocar ni medir nada), y los permisos se dan sobre tablas concretas, nunca GRANT ALL ON *.* “mientras probamos”.
10. Migraciones de esquema y backups que restauran
No todos los ALTER cuestan lo mismo
Añadir una columna es una operación de metadatos: instantánea, sin reescribir nada.
ALTER TABLE events ADD COLUMN pais LowCardinality(String) DEFAULT '';Cambiar el tipo de una columna es una mutación: reescribe todas las partes afectadas.
ALTER TABLE events MODIFY COLUMN duration_ms UInt64
SETTINGS mutations_sync = 2;
En una tabla de mil millones de filas, lo primero tarda milisegundos y lo segundo puede tardar horas y saturar el pool de merges. Antes de lanzar un MODIFY COLUMN en producción, pruébalo sobre una copia de una partición y mide. Y usa ON CLUSTER para la DDL distribuida, verificando después system.distributed_ddl_queue, porque un DDL que falla en un solo nodo deja el clúster inconsistente en silencio.
Si necesitas tocar un límite solo en una tabla, no cambies el servidor entero:
ALTER TABLE events MODIFY SETTING parts_to_throw_insert = 3000;Un backup que no has restaurado no es un backup
BACKUP necesita un disco declarado explícitamente como permitido; sin esa configuración el comando falla, y descubrirlo el día del incidente es tarde:
<!-- /etc/clickhouse-server/config.d/backups.xml -->
<clickhouse>
    <storage_configuration>
        <disks>
            <backups>
                <type>local</type>
                <path>/var/lib/clickhouse/backups/</path>
            </backups>
        </disks>
    </storage_configuration>
    <backups>
        <allowed_disk>backups</allowed_disk>
    </backups>
</clickhouse>
Con eso, el ciclo completo funciona, y es exactamente el que deberías ensayar en un entorno de pruebas cada trimestre:
BACKUP TABLE estados TO Disk('backups', 'estados.zip');

DROP TABLE estados SYNC;

RESTORE TABLE estados FROM Disk('backups', 'estados.zip');
En producción, cambia Disk('backups', ...) por S3(...) y añade ASYNC para no bloquear la sesión. Lo que no cambia es la regla: si nunca has ejecutado el RESTORE, no tienes copia de seguridad, tienes una carpeta.
11. Observabilidad: las consultas que debes tener a mano
La métrica de salud número uno es el número de partes activas:
SELECT
    database,
    table,
    count() AS partes,
    sum(rows) AS filas,
    formatReadableSize(sum(bytes_on_disk)) AS tamano
FROM system.parts
WHERE active AND database = currentDatabase()
GROUP BY database, table
ORDER BY partes DESC;
Las consultas más caras, agrupadas por forma y no por texto literal, que es lo que hace útil a normalized_query_hash:
SELECT
    normalized_query_hash,
    count() AS ejecuciones,
    formatReadableSize(avg(memory_usage)) AS memoria_media,
    round(avg(query_duration_ms)) AS ms_medios,
    formatReadableQuantity(avg(read_rows)) AS filas_leidas
FROM system.query_log
WHERE type = 'QueryFinish' AND event_time >= now() - INTERVAL 1 DAY
GROUP BY normalized_query_hash
ORDER BY avg(query_duration_ms) DESC
LIMIT 20;
Y la consulta que convierte “me parece que va lento” en un número: cuántas marcas y cuántas filas tocó de verdad una consulta concreta.
SELECT
    ProfileEvents['SelectedMarks']    AS marcas,
    ProfileEvents['SelectedRanges']   AS rangos,
    formatReadableQuantity(read_rows) AS filas_leidas,
    formatReadableSize(read_bytes)    AS bytes_leidos
FROM system.query_log
WHERE type = 'QueryFinish'
  AND query LIKE '%FROM events WHERE tenant_id = 5%'
  AND event_time >= now() - INTERVAL 10 MINUTE
ORDER BY event_time DESC
LIMIT 1;
Esta es, de lejos, la herramienta más infrautilizada de ClickHouse. Todas las cifras de este artículo salen de ahí.
Y una advertencia sobre el propio query_log: en la imagen oficial se crea sin TTL. Crece hasta que se llena el disco, y entonces pierdes a la vez la base de datos y el histórico que te habría dicho por qué. Compruébalo y ponle fecha de caducidad:
SELECT engine_full FROM system.tables
WHERE database = 'system' AND name = 'query_log';
El resto del arsenal: system.merges y system.mutations para el almacenamiento, system.replication_queue y system.replicas para el retraso de replicación, system.kafka_consumers si ingieres de Kafka, system.errors para lo que realmente está fallando, y system.asynchronous_metrics para alimentar Prometheus y Grafana.
Alerta sobre cinco cosas y dormirás tranquilo: partes activas, retraso de replicación, mutaciones sin terminar, memoria del servidor y espacio en disco.
En el host, lo de siempre: NVMe para datos calientes, almacenamiento por niveles para el resto, swap desactivado, max_server_memory_usage en torno al 80% de la RAM, límite de ficheros abiertos alto y transparent huge pages desactivadas.
12. Antipatrones: lo que nunca debes hacer
Usar ClickHouse como base OLTP: no hay transacciones multi-sentencia, ni actualizaciones puntuales rápidas, ni unicidad garantizada.
Usarlo como key-value store para leer una fila por clave. Para eso está Redis.
Insertar fila por fila sin
async_insert.Hacer
SELECTa una tabla conENGINE = Kafka.Ejecutar
OPTIMIZE FINALen un cron.Dejar
SELECT *en código de aplicación.Particionar por una columna de alta cardinalidad.
Confiar en que
ReplacingMergeTreededuplica al instante.Permitir consultas sin perfil de ajustes ni cuota.
Dar acceso a herramientas externas con el usuario
default.Guardar
DateTimesin zona horaria explícita.Dejar
system.query_logsinTTL.Tener un solo nodo, sin réplicas, para datos que no puedes perder.
Llamar backup a algo que nunca has restaurado.
Asumir que la clave primaria es única. En ClickHouse no lo es.
13. Preguntas frecuentes
¿Sirve ClickHouse como base de datos transaccional?
No. ClickHouse es una base analítica (OLAP) orientada a columnas. No tiene transacciones multi-sentencia, las actualizaciones por fila son mutaciones asíncronas que reescriben partes enteras, y la clave primaria no impone unicidad. Para OLTP, usa PostgreSQL o MySQL y replica hacia ClickHouse lo que necesites analizar.
¿Cada cuánto debo insertar en ClickHouse?
Como mucho una vez por segundo y por tabla desde cada productor, con lotes de 10.000 filas o más. Si tu arquitectura no te deja agrupar, activa async_insert = 1 y deja que el servidor lo haga por ti.
¿Qué significa el error TOO_MANY_PARTS?
Que estás creando partes más rápido de lo que el motor puede fusionarlas. En las versiones actuales, ClickHouse empieza a retrasar los INSERT a partir de 1.000 partes activas por partición y los rechaza a partir de 3.000. Casi siempre la causa es ingesta fila por fila o una partición de cardinalidad demasiado alta. La solución es arreglar la ingesta, no subir el límite.
¿Cuántas columnas debe tener la ORDER BY?
Entre dos y cuatro, ordenadas de menor a mayor cardinalidad, empezando por lo que siempre filtras. Más columnas encarecen los merges sin mejorar la poda.
¿Cuándo uso una vista materializada y cuándo una proyección?
Proyección si necesitas otra ORDER BY sobre los mismos datos y quieres que el motor la mantenga solo. Vista materializada si lo que repites son agregaciones y quieres preagregar en el momento de la ingesta. Si el patrón es completamente distinto, una tabla aparte.
¿Por qué mi consulta con FINAL va lenta?
Porque FINAL fusiona las partes en tiempo de consulta para darte la última versión de cada fila. Sustitúyelo por una agregación explícita con argMax y GROUP BY, cuidando de que los alias no se llamen igual que las columnas agregadas.
¿Cómo aíslo a varios clientes en la misma tabla de ClickHouse?
Con una política de filas (CREATE ROW POLICY ... USING tenant_id = ...) por usuario, además de un perfil de ajustes y una cuota. Filtrar por tenant solo en la aplicación no es aislamiento: cualquier consulta directa se lo salta.
¿Cómo leo de Kafka sin perder mensajes?
Con tres objetos: una tabla ENGINE = Kafka, una vista materializada y una tabla MergeTree de destino. Nunca consultes directamente la tabla Kafka, porque cada lectura consume del topic.
¿ClickHouse necesita índices como PostgreSQL?
No en el mismo sentido. El índice primario es disperso y se deriva de la ORDER BY; no hay índices B-tree por fila. Los índices de salto son un complemento para columnas fuera de la clave, y solo valen la pena si son muy selectivos.
14. La lista, en una pantalla
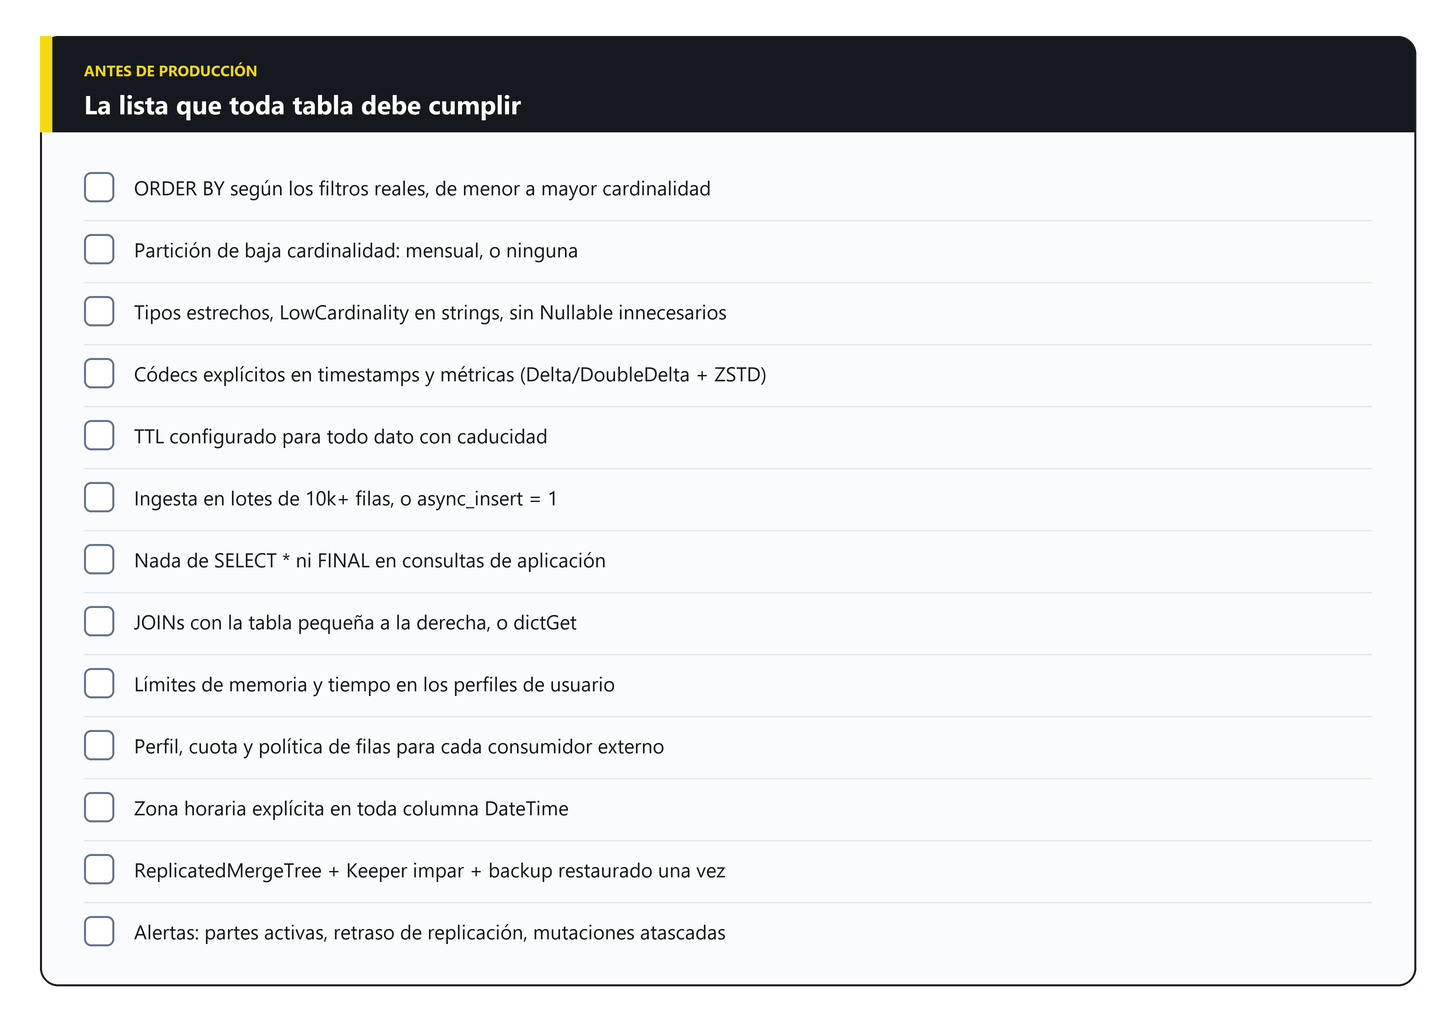
Cómo reproducir todo esto en tu máquina
Todo el SQL de este artículo —56 bloques, incluidas las mediciones, los backups y la seguridad— se ejecutó contra ClickHouse 26.9 antes de publicarlo. Puedes repetirlo en cinco minutos:
docker run -d --name ch-blog \
  --ulimit nofile=262144:262144 \
  clickhouse/clickhouse-server:latest

docker exec -it ch-blog clickhouse-client
Crea la tabla events de la sección 1, cárgala con datos sintéticos y mide tú mismo:
INSERT INTO events
SELECT
    number % 50                                   AS tenant_id,
    ['click','view','purchase'][number % 3 + 1]   AS event_type,
    number % 100000                               AS user_id,
    now() - toIntervalSecond(number % 5184000)    AS event_time,
    number % 900                                  AS duration_ms,
    toDecimal64(number % 100, 4)                  AS revenue,
    repeat('x', 40)                               AS payload
FROM numbers(2000000);
Dos millones de filas en unos segundos, y ya puedes comparar planes con EXPLAIN indexes = 1 y marcas leídas en system.query_log. Medir en tu propio hardware, con tu propio esquema, vale más que cualquier lista de buenas prácticas. Incluida esta.
Si cumples esta guía, ClickHouse te devuelve agregaciones sobre miles de millones de filas en menos de un segundo. Si no, vas a culpar a la base de datos de algo que está escrito en tu CREATE TABLE.
La documentación oficial de ClickHouse es excelente y conviene tenerla cerca, sobre todo las páginas de MergeTree, vistas materializadas y control de acceso.
¿Te has peleado con alguno de estos puntos en producción? Cuéntamelo en los comentarios: la lista está viva, y hay errores que solo se aprenden a las tres de la mañana.